

Поймёте, как вывести уникальные значения Excel формулой, соберёте обновляемый список и отличите реальный дубль от одинаковых на вид записей.
В выгрузке 20 000 заказов, а городов вроде бы 48. «Вроде бы» — потому что Москва, `Москва ` с пробелом и МОСКВА могут вести себя как разные значения в разных операциях. Функция УНИК (UNIQUE) возвращает отдельный динамический массив без ручного удаления дублей. Исходник остаётся на месте, а список автоматически расширяется или сокращается после обновления.
Что это значит простыми словами
Формула =УНИК(A2:A20001) выводит каждое уникальное значение из диапазона. Результат разливается вниз, поэтому ячейки под формулой должны быть свободны. Второй аргумент позволяет искать уникальные столбцы вместо строк, третий — вернуть только значения, встречающиеся ровно один раз. Это не то же самое, что обычный список без повторов: параметр «встречается один раз» исключит все дубли целиком.
Как работает логика
Для списка по условию функции соединяют: =СОРТ(УНИК(ФИЛЬТР(B2:B20001;C2:C20001="Активен"))). Сначала ФИЛЬТР оставляет активных клиентов, УНИК убирает повторения, СОРТ приводит список в удобный порядок. Если нужны уникальные комбинации города и менеджера, передайте два соседних столбца. Функция будет сравнивать целые строки, а не каждый столбец отдельно.
Подробный пример с числами
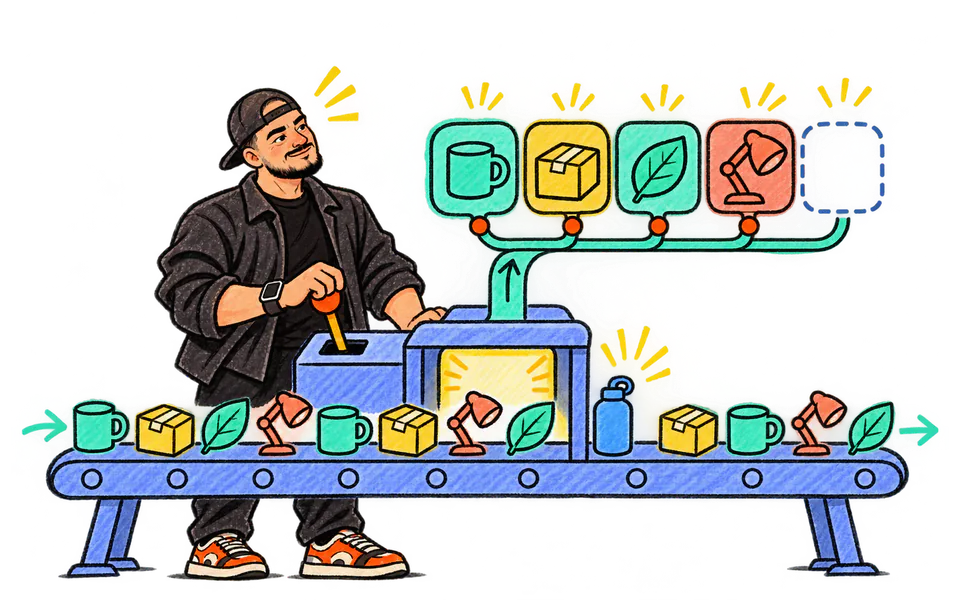
Есть 20 000 заказов от 6 240 клиентов. =УНИК(client_id) возвращает 6 240 идентификаторов. После ФИЛЬТР по статусу «Оплачен» остаётся 5 180 уникальных покупателей. Значит, 1 060 клиентов пока не имеют оплаченного заказа в выбранном наборе. Если общая выручка оплаченных заказов равна 77,7 млн рублей, выручка на уникального покупателя составляет 77,7 млн / 5 180 = 15 000 рублей. Это другой показатель, чем средний чек по 8 900 заказам — там получится около 8 730 рублей.
Сверьте количество строк разлившегося массива через СТРОКИ(УНИК(...)) и сравните со сводной таблицей с уникальным подсчётом либо проверкой в источнике. Найдите пустое значение: УНИК может вернуть его как отдельный элемент. Проверьте длину текста и очистку пробелов. Если после СЖПРОБЕЛЫ количество уникальных городов уменьшилось с 51 до 48, проблема была в качестве справочника, а не в функции.
Как использовать в бизнесе
Уникальные списки нужны для выпадающих полей, контроля справочников, подсчёта клиентов и подготовки небольших отчётов. В проектах я чаще всего использую УНИК как сигнал качества данных. Если в CRM должно быть 12 регионов, а формула показывает 16, сначала исправляем написание и идентификаторы. И только потом строим аналитику: красивый дашборд не умеет сам догадаться, что «СПб» и «Санкт-Петербург» — один город.
Когда применять этот подход
УНИК подходит для динамического результата в современных версиях Excel. «Удалить дубликаты» меняет исходный диапазон и годится для разовой очистки копии. Расширенный фильтр создаёт статический список. Power Query лучше, если требуется регулярная нормализация большого набора, объединение справочников и журнал шагов. Для бизнес-показателя предпочтительнее устойчивый client_id, а не имя или телефон в свободном формате.
Как проверить результат
Преобразуйте исходник в таблицу Excel и используйте структурированную ссылку — тогда новый заказ попадёт в формулу автоматически. Не ставьте данные внутри области разлива: появится ошибка #ПЕРЕНОС!. Проверьте пустые строки, пробелы, регистр, неразрывные пробелы и числа, записанные текстом. Отдельно сохраните правило нормализации: формула без него лишь покажет последствия грязного справочника.
Порядок действий
1. Выберите устойчивое поле
Для клиентов используйте идентификатор, а не ФИО, если он доступен.
2. Очистите очевидные различия
Уберите лишние пробелы и приведите справочные значения к одному стандарту.
3. Постройте УНИК
Убедитесь, что под формулой есть место для динамического массива.
4. Добавьте условие и сортировку
Соедините ФИЛЬТР, УНИК и СОРТ только после проверки каждого шага.
5. Сверьте количество
Сравните число уникальных значений с независимым расчётом.
Ограничения и типичные ошибки
- Считать уникальными клиентов по имени.
- Путать список без дублей со значениями, встречающимися ровно один раз.
- Игнорировать пустые значения и пробелы.
- Размещать ручные данные в зоне динамического массива.
После изменения источника или структуры таблицы повторите контрольный пример. Старое совпадение не подтверждает новую версию данных автоматически.
Как я делаю это в проектах
Я начинаю с идентификатора и десяти подозрительных значений. Смотрим, почему они различаются, исправляем справочник или шаг очистки, снова считаем уникальные. После этого связываем количество с деньгами: клиенты, заказы, выручка и выручка на клиента. Так функция становится частью управленческого расчёта, а не просто удобным способом сделать короткий список. Если правило очистки нельзя объяснить словами, его рано автоматизировать.
Что сделать прямо сейчас
Выведите уникальный список по одному важному справочнику, сравните количество до и после очистки пробелов и разберите каждое расхождение.
Если хотите связать расчёт с реальным управленческим решением, можно обсудить задачу с ФАНалитикой. Начнём с одного проверяемого сценария и понятной цифры.


