

Руководитель просит новый срез. Аналитик ставит задачу в очередь. Через пять дней вопрос уже поменялся. Так появляется идея: «Давайте каждый будет строить отчёты сам». Звучит прекрасно.
А потом отделы создают 73 модели, три календаря и семь формул маржи. Self-Service BI работает, когда самостоятельность ограничена понятными рельсами. Рельсы тут хорошие — они не мешают ехать, они помогают доехать.
Что получите после чтения
Поймёте, что такое Self-Service BI, кому его можно давать и какие правила нужны, чтобы самостоятельная аналитика не создала десять версий выручки. В конце будет конкретный первый шаг, который можно сделать на своих данных сегодня.
Что это такое простыми словами
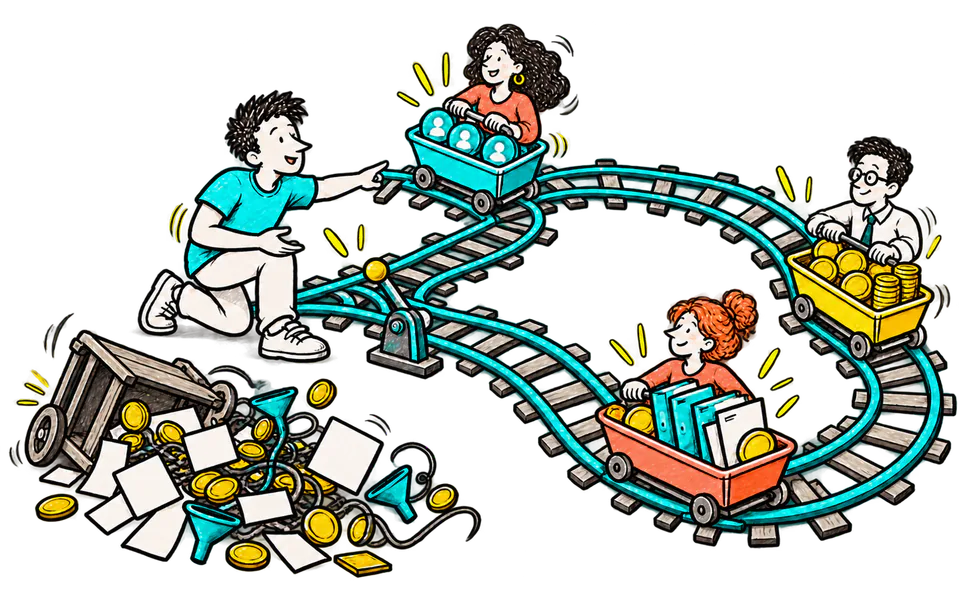
Self-Service BI — подход, при котором бизнес-пользователь сам исследует данные, меняет фильтры, строит срезы и иногда создаёт отчёты без постоянной очереди к разработчику.
Это не означает прямой доступ ко всем сырым таблицам. Зрелая модель даёт сертифицированные наборы данных: в них уже определены клиенты, продажи, календарь, доступы и базовые показатели.
IT и аналитики отвечают за платформу, качество, безопасность и повторно используемые модели. Пользователь — за вопрос, интерпретацию и решение в своей зоне.
Как эту задачу ищут и обсуждают
Люди формулируют этот вопрос по-разному: «self service bi что это», «аналитика самообслуживания», «самостоятельная бизнес аналитика». Чуть глубже спрашивают «как внедрить self service bi», «self service bi и governance» и «self service аналитика для бизнеса». В работе всплывают и практические варианты: «роль it в self service bi», «сертифицированные наборы данных bi», «риски self service bi», «модель самообслуживания в bi». Ниже всё это собрано в одну понятную логику — без десяти статей об одном и том же.
Что это даёт бизнесу
Команда быстрее проверяет гипотезы. Маркетолог сам сравнивает кампании, руководитель продаж открывает нужный сегмент, финансист уточняет период — без нового технического задания на каждое движение фильтра.
Аналитики перестают быть службой экспорта в Excel и тратят время на модель, сложные исследования и контроль качества. Но экономия появляется только после стандартизации частых запросов.
Порядок действий
- Разделите пользователей на роли: читатель, исследователь, автор отчёта и разработчик модели.
- Соберите десять повторяющихся вопросов каждой роли. Они станут основой первых наборов.
- Подготовьте сертифицированные модели с понятными названиями, описаниями и владельцами.
- Настройте доступ на уровне строк и объектов, проверьте его тестовыми пользователями.
- Обучите людей на их реальном отчёте: вопрос → фильтр → проверка → вывод.
- Создайте площадку поддержки и короткий процесс сертификации нового отчёта.
- Раз в месяц смотрите использование, дубли и ошибки, а ненужные модели спокойно закрывайте.
Первый проход лучше сделать на одном закрытом периоде и одной понятной группе. Так легче проверить исходные записи и не прятать ошибку внутри большого среднего. После сверки правило можно переносить в автоматический отчёт.
Формула или логика расчёта
Полезная логика оценки проста: время, которое команда сэкономила на типовых вопросах, должно быть больше времени на поддержку моделей, обучение и контроль. Только лицензии в расчёте дают слишком бодрую картину.
Для использования можно считать долю активных целевых пользователей: активные пользователи за месяц ÷ пользователи, которым BI нужен по роли. Рядом смотрим не клики, а регулярность управленческих встреч и решения, принятые по данным.
Пример с числами
В отделе продаж 25 руководителей групп. До запуска они отправляли аналитикам 80 запросов в месяц. Средняя подготовка занимала 35 минут: почти 47 часов работы.
Команда создала сертифицированный набор со сделками, менеджерами, стадиями и планом. 20 руководителей используют его еженедельно. Число типовых запросов снизилось до 22, но добавилось 12 часов поддержки и обучения.
Экономия аналитиков: (80 − 22) × 35 минут = 33,8 часа. Минус 12 часов поддержки — около 22 часов в месяц. Это уже измеримый результат.
На встрече мы замечаем другое: пять руководителей не пользуются моделью. Оказывается, у них не сходится региональный план. Исправляем справочник и повторяем обучение на их сценарии. Adoption вырос не после письма «пользуйтесь чаще», а после устранения конкретной причины.
Как разделить свободу пользователей и ответственность платформы
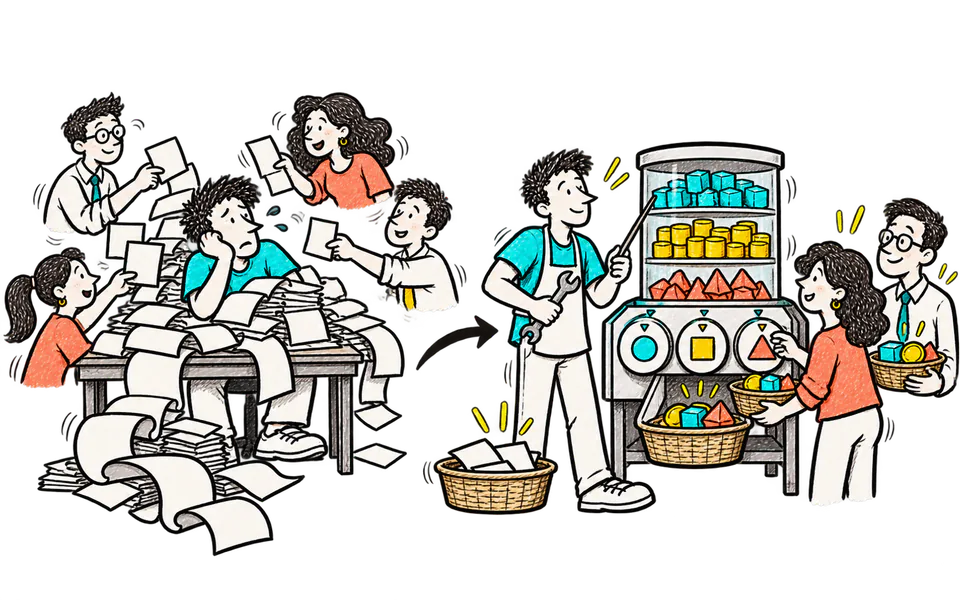
Полезно нарисовать четыре зоны. В первой — сертифицированные модели и показатели, менять их может только ответственная команда. Во второй — общие отчёты, которые проходят короткую проверку. В третьей — личные исследования пользователя. В четвёртой — сырые данные с ограниченным доступом. Тогда слово «самостоятельно» перестаёт означать «как угодно».
Для автора отчёта заведите простой паспорт: цель, аудитория, источник, владелец, частота, критичные формулы и дата последнего использования. Если отчётом никто не пользовался три месяца, его можно архивировать. Это снижает шум и не заставляет новых сотрудников выбирать между двенадцатью одинаковыми ссылками.
Обучение лучше строить сериями по 30–40 минут. На первой встрече человек находит нужный показатель. На второй собирает свой срез. На третьей проверяет число до отправки руководителю. Между встречами остаётся маленькая рабочая задача. Так навык закрепляется на реальном процессе, а не растворяется после демонстрации функций.
Отдельно следите за экспортами. Если активный пользователь каждую неделю выгружает данные и строит те же формулы в Excel, это не провал. Это сигнал: в сертифицированной модели не хватает расчёта, детализации или удобного сценария.
Короткий контрольный список
- Роли и доступы определены
- Есть сертифицированные наборы
- Черновики отделены от общих отчётов
- Поддержка отвечает по понятному каналу
- Экспорты и дубли регулярно разбираются
Как автоматизировать и не потерять контроль
Автоматизацию ставим после ручной сверки двух сопоставимых периодов. В процессе должны остаться четыре вещи: контроль входа, контроль результата, понятный статус свежести и человек, который принимает решение при отклонении. Иначе ручная ошибка просто научится бегать быстрее.
Обновление сертифицированных наборов и тесты качества автоматизируйте централизованно. Пользователь должен видеть дату свежести, статус и владельца, а при сбое — последнее успешное обновление с заметным предупреждением.
Usage-логи раз в месяц объединяйте с реестром отчётов. Так видны активные модели, дубли, забытые публикации и частые экспорты. Решение об архиве принимает владелец, а не безжалостный скрипт в воскресенье.
- Контрольная сумма и число строк
- Дата и статус последнего успешного обновления
- Журнал изменений методики
- Владелец реакции на предупреждение
Перед включением расписания сохраните эталонную выгрузку и десять проверенных объектов с ожидаемым результатом. После каждого заметного изменения прогоняйте их снова. Общая сумма ловит крупный разрыв, а конкретные объекты показывают, не поменялась ли логика внутри. Если проверка не прошла, новая версия не заменяет рабочую — она остаётся на тестовом контуре до разбора причины.
Результат проверки тоже сохраняйте: дата, версия правил, входной период и найденные расхождения. Тогда через месяц можно объяснить, почему число изменилось, а не восстанавливать методику по памяти команды.
Как объяснить результат команде
Я показываю не только итоговую цифру. Рядом ставлю период, базу сравнения, размер выборки и одно предложение о причине. Тогда процент превращается в рабочий вывод, а не в число, которое каждый трактует по настроению.
Следующий слой — действие. У него есть владелец и дата проверки. Если изменение относится к рекламе, задача уходит маркетологу. Если к CRM — продажам. Если расходятся определения, сначала собираем владельцев показателя. Дашборд сам людей не познакомит (пока что).
Что проверить глубже
- Дайте пользователю безопасное место для черновика и отдельный путь публикации общего отчёта.
- Показывайте происхождение показателя и дату обновления прямо рядом с моделью.
- Ограничьте создание новых мер там, где уже есть утверждённая формула.
- Следите за дубликатами: десять почти одинаковых отчётов снова создают ручную сверку, только теперь она очень современная.
Полезно взять пять крупных объектов и пять случайных. Крупные находят денежные отклонения, случайные — системные. Для каждого пройдите путь до источника: дата, статус, сумма, идентификатор и правило включения.
Ограничения и типичные ошибки
- Выдать сырые данные всем и назвать это демократизацией
- Обучать интерфейсу без рабочих задач
- Считать созданный отчёт доказательством пользы
- Не назначать владельца сертифицированного набора
- Не проверять доступы и выгрузки персональных данных
Ограничение не делает метод бесполезным. Оно показывает границу, внутри которой результат можно использовать. Если граница записана рядом, решение получается спокойнее и точнее.
Как я использую это в работе
Я спрашиваю у собственника, какие решения должны приниматься без участия аналитика. Потом мы выбираем две роли и пять частых вопросов. Этого хватает для первого контура.
Маркетолог получает сертифицированные расходы, лиды, продажи и маржу. Он может менять сегмент и период, но не переписывает определение CAC внутри своего файла. Если нужен новый показатель, мы вместе проверяем его смысл и источник.
Через месяц я смотрю не на количество графиков. Смотрю, кто использует набор, какие вопросы всё ещё уходят в чат и где люди выгружают данные вручную. Там и лежит следующий шаг. Кнопка ниже — если хотите собрать управляемый Self-Service BI без корпоративного квеста.
Как поставить показатель на контроль
После первого расчёта сохраняем исходную версию и контрольную выборку. Затем задаём частоту обновления, допустимое отклонение и реакцию. Сигнал без реакции быстро превращается в ещё одно уведомление, которое все научились закрывать.
Через один полный рабочий цикл сравниваем ожидание с фактом. Ошибки делим на три группы: данные, допущение и исполнение. Это важно: исправлять загрузку, менять прогноз и дорабатывать процесс — три разные задачи.
Что сделать прямо сейчас
Выберите одну роль и выпишите десять вопросов, которые она задаёт каждый месяц. Отметьте, какие можно закрыть одним сертифицированным набором данных. Это будет честный первый backlog.


