

Поймёте GROUP BY простыми словами, соберёте агрегированный отчёт и разберётесь, почему WHERE и HAVING фильтруют данные на разных этапах.
В таблице продаж может быть миллион строк, но собственнику не нужен миллион чеков. Ему нужны итоги по месяцам, каналам или продуктам. GROUP BY превращает детальные строки в такие группы. После группировки SQL применяет COUNT, SUM, AVG, MIN или MAX. Важно заранее решить, что означает одна строка результата. Если это «месяц + канал», каждый выбранный неагрегированный столбец должен входить в GROUP BY.
Что это значит простыми словами
Запрос SELECT channel, SUM(revenue) FROM orders GROUP BY channel вернёт по одной строке на каждый канал. Все заказы одного канала собираются вместе, затем их выручка суммируется. COUNT(*) посчитает строки, COUNT(client_id) — непустые значения, а COUNT(DISTINCT client_id) — уникальных клиентов. Эти числа могут сильно различаться, поэтому функция выбирается не по привычке, а по бизнес-вопросу.
Как работает логика
Упрощённый порядок такой: FROM и JOIN формируют набор, WHERE отбрасывает отдельные строки, GROUP BY создаёт группы, агрегаты считают показатели, HAVING отбрасывает уже готовые группы, ORDER BY сортирует результат. Поэтому условие order_date >= DATE '2026-10-01' ставят в WHERE, а SUM(revenue) > 1000000 — в HAVING. Если перепутать этапы, запрос либо не выполнится, либо ответит на другой вопрос.
Подробный пример с числами
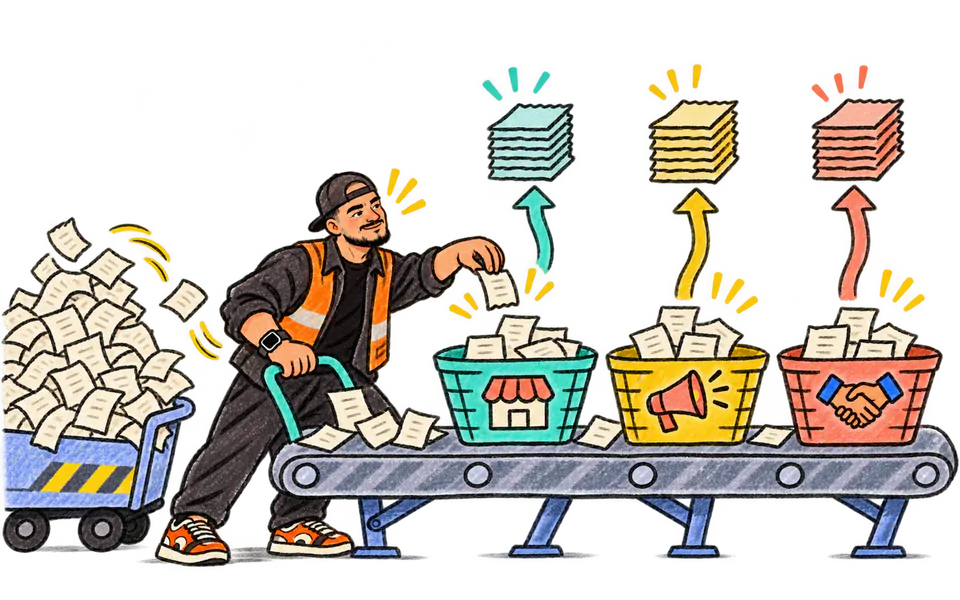
Есть 42 000 заказов за октябрь. Запрос группирует их по channel и считает COUNT(*) AS orders, COUNT(DISTINCT client_id) AS clients, SUM(revenue) AS revenue. Канал «Контекст» дал 8 400 заказов, 6 100 клиентов и 12,6 млн рублей. Средний чек равен 12,6 млн / 8 400 = 1 500 рублей, а заказов на клиента — 8 400 / 6 100 = 1,38. HAVING SUM(revenue) >= 1 000 000 оставит только заметные каналы, но исходные 42 000 строк не изменит.
Сверьте сумму revenue по всем группам с общей суммой по тому же WHERE без GROUP BY. Оба результата должны совпасть, если группы взаимно исключаются и JOIN не размножил строки. Затем сравните COUNT(*) с количеством исходных заказов. Если итог стал больше, проверьте связь с таблицей рекламных касаний: один заказ мог соединиться с несколькими строками атрибуции и задвоить выручку.
Как использовать в бизнесе
В проектах GROUP BY лежит под большинством управленческих показателей: продажи по каналам, маржа по продуктам, обращения по статусам. Но SQL не знает бизнес-определений. Он честно сгруппирует отменённые заказы вместе с оплаченными, если мы не задали фильтр. Поэтому перед запросом мы фиксируем период, статус, валюту, НДС и дату отнесения. После этого агрегат становится показателем, которому можно доверять.
Когда применять этот подход
GROUP BY нужен, когда деталь надо свернуть до категорий. Оконные функции подходят, если требуется сохранить каждую исходную строку и рядом показать итог группы или место в рейтинге. DISTINCT только убирает повторяющиеся комбинации и ничего не считает. Подзапрос или CTE удобен, когда сначала нужно агрегировать один уровень, а потом использовать его в следующем расчёте.
Как проверить результат
Перед запуском выпишите зерно исходной таблицы и зерно результата. Для таблицы orders это может быть одна строка на заказ, для результата — одна строка на месяц и канал. Проверьте NULL: GROUP BY соберёт пустые значения в отдельную группу. Решите, нужно ли назвать её «Не определено» или исправить источник. Не прячьте такую группу автоматически — иногда именно она показывает сломавшуюся разметку.
Порядок действий
1. Сформулируйте строку результата
Например: один месяц и один рекламный канал.
2. Отберите исходные строки
Задайте период и бизнес-статусы в WHERE.
3. Добавьте измерения
Все выбранные поля без агрегата включите в GROUP BY.
4. Посчитайте показатели
Выберите COUNT, SUM или другой агрегат согласно определению.
5. Проверьте и только потом фильтруйте группы
Сверьте итоги, затем используйте HAVING и ORDER BY.
Ограничения и типичные ошибки
- Группировать после JOIN, который размножил факты.
- Путать WHERE и HAVING.
- Считать COUNT(column) как все строки при наличии NULL.
- Добавлять столбцы в GROUP BY без понимания нового зерна результата.
После изменения источника или структуры таблицы повторите контрольный пример. Старое совпадение не подтверждает новую версию данных автоматически.
Как я делаю это в проектах
Я всегда начинаю с контрольного запроса на общую сумму и количество. Потом добавляю одно измерение и смотрю, сходится ли итог. Затем второе. Такой путь чуть медленнее первых пяти минут, зато быстро показывает, где данные задвоились. В разговоре с владельцем бизнеса мы отдельно проговариваем, что такое заказ и в какой день он считается продажей. SQL получается последним шагом, а не заменой этой договорённости.
Что сделать прямо сейчас
Возьмите один рабочий запрос с GROUP BY и подпишите рядом зерно исходной таблицы, зерно результата и контрольную сумму.
Если хотите связать расчёт с реальным управленческим решением, можно обсудить задачу с ФАНалитикой. Начнём с одного проверяемого сценария и понятной цифры.


