

Данные нужно забрать из CRM, рекламы и учётной системы, очистить и положить в хранилище. Что делать первым: преобразовывать или загружать? Из перестановки двух букв вырос отдельный архитектурный спор.
ETL и ELT решают одну задачу разным порядком. Бизнесу важен не термин, а скорость запуска, стоимость повторного расчёта, безопасность и способность восстановить цифру.
Что это такое простыми словами
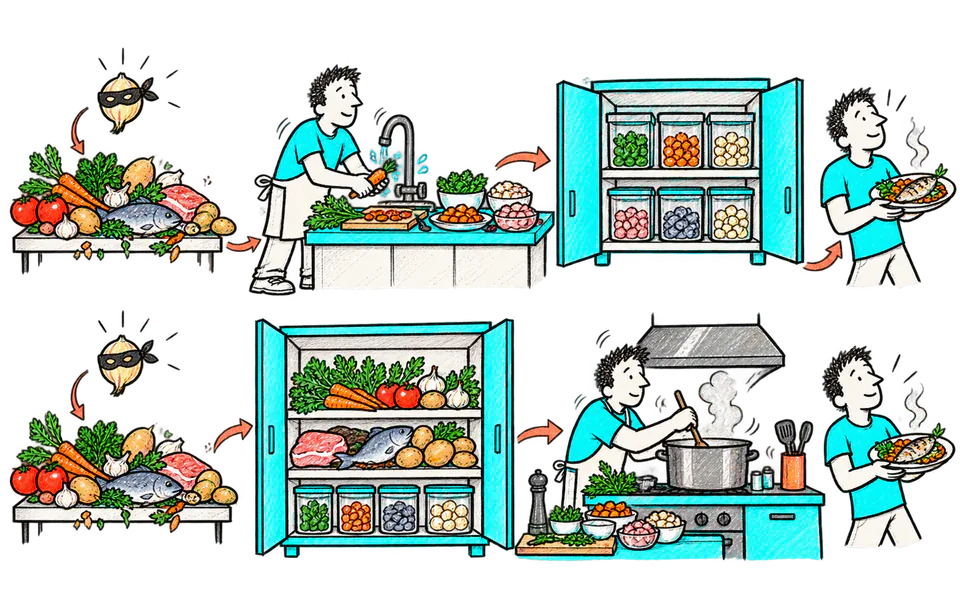
ETL означает extract, transform, load: извлекли, преобразовали, загрузили. Данные проходят очистку и приведение к структуре до целевого хранилища.
ELT означает extract, load, transform: извлекли, загрузили сырой слой, затем преобразовали средствами целевой платформы. Современные облачные хранилища сделали этот подход популярным благодаря масштабируемым вычислениям.
На практике процессы смешиваются. Чувствительные поля можно удалить до загрузки, а тяжёлые бизнес-преобразования выполнить уже внутри хранилища.
Зачем это бизнесу
ETL удобен, когда целевая система принимает только строгую структуру, вычисления в ней дороги или данные нельзя хранить в сыром виде. Контроль происходит до входа.
ELT удобен, когда нужно быстро сохранить полную историю, часто менять правила и использовать мощность облачной платформы. Новый расчёт можно выполнить из сырого слоя без повторной выгрузки источника.
Цена ошибки разная. В ETL потерянное поле может потребовать новой загрузки. В ELT лишний сырой объём повышает требования к доступам, каталогу и стоимости хранения.
Как сделать: пошаговый порядок
- Опишите целевой отчёт и требуемую детализацию, а не весь возможный поток.
- Проверьте объём, частоту изменений, лимиты источников и окно загрузки.
- Разделите обязательные преобразования безопасности и бизнес-логику.
- Решите, где хранить сырой слой и сколько времени он нужен.
- Соберите идемпотентную загрузку: повторный запуск не должен создавать дубли.
- Добавьте тесты количества строк, ключей, свежести и контрольных сумм.
Формула или логика расчёта
Сравнивайте полную стоимость потока: разработка + оркестрация + хранение + вычисления + поддержка + цена восстановления. Дешёвая первая загрузка может оказаться дорогой при каждом изменении правила.
Подробный пример с числами
Компания ежедневно получает 5 млн рекламных событий и 30 тысяч заказов. Отчёт по марже обновляется утром, а аналитики раз в неделю исследуют новые признаки.
В ETL-варианте события очищались на отдельном сервере четыре часа, затем грузились в DWH. Добавление нового поля требовало менять процесс и иногда повторно забирать историю. В ELT-варианте сырой поток сохранялся за 70 минут, а модели строились внутри платформы.
Стоимость вычислений внутри хранилища выросла на 90 тысяч рублей в месяц, зато команда сократила поддержку на 50 часов. При внутренней стоимости часа 2 500 рублей экономия времени составила 125 тысяч. Чистый эффект — около 35 тысяч плюс более быстрые изменения.
Часть персональных данных продолжили маскировать до загрузки. Получился гибрид — и это нормально. Архитектура не обязана сдавать экзамен на чистоту термина.
Как сравнить ETL и ELT на одном потоке
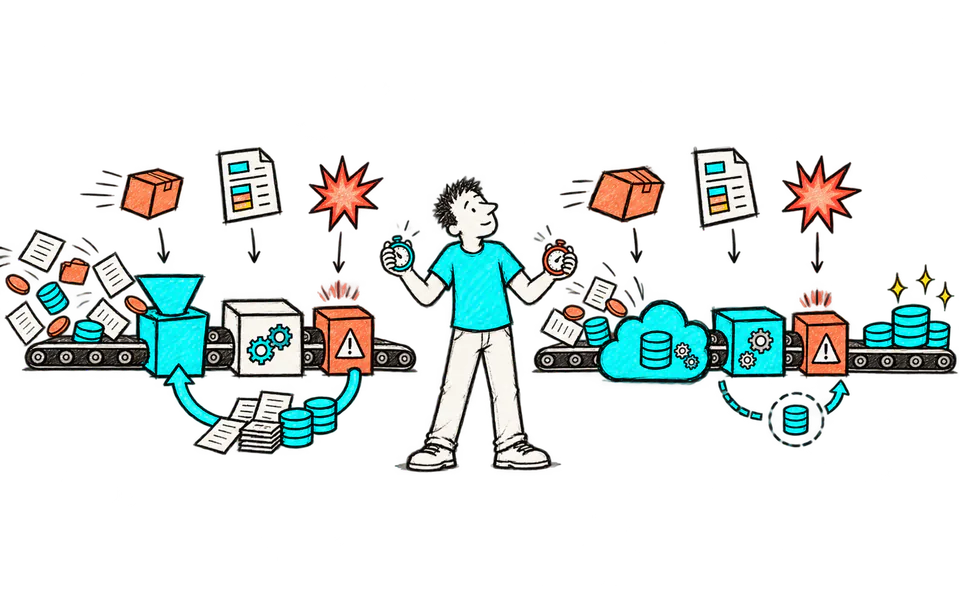
Соберите два маленьких прототипа на одинаковом наборе. Замерьте время первичной загрузки, повторного пересчёта, добавления нового поля и восстановления после ошибки. Один удачный запуск почти ничего не говорит о будущей эксплуатации.
В ETL зафиксируйте, где хранится промежуточное состояние. Если преобразование упало на 90% объёма, нужно ли забирать всё заново? Хороший процесс умеет продолжить с понятной точки и не создавать дубли.
В ELT измерьте объём сканирования и стоимость вычислений. Запрос, который каждый раз читает весь сырой слой, может быть простым в разработке и дорогим в эксплуатации. Инкрементальные модели и разбиение по датам здесь важнее названия подхода.
Проверьте поздние изменения. Заказ мог изменить статус через неделю, рекламная система — пересчитать атрибуцию, ERP — провести документ задним числом. Поток должен знать, какой период пересчитать и как сохранить историю изменений.
Отдельно опишите персональные и коммерчески чувствительные данные. Какие поля можно загрузить, какие маскируются, кто имеет доступ к сырому слою и когда он удаляется? Гибкость ELT не отменяет минимизацию данных.
По итогам сравните не только минуты и рубли. Добавьте время инженера, прозрачность отладки, доступность специалистов и зависимость от платформы. Архитектура должна быть поддерживаемой вашей командой, а не идеальной командой из презентации.
Короткий чек-лист
- одинаковый тестовый набор
- повторный запуск без дублей
- поздние изменения
- стоимость вычислений
- права и сроки хранения
- время команды на поддержку
Как превратить расчёт в решение
Контракт источника фиксирует схему, обязательные поля и допустимые изменения. Если API добавил колонку, процесс может продолжить работу. Если исчез идентификатор заказа, загрузка должна остановиться и сообщить причину, а не тихо собрать половину отчёта.
Оркестрация хранит зависимости. Витрина не обновляется раньше сырого слоя, а отчёт не получает статус готовности до успешных тестов. Это одинаково важно для ETL и ELT: порядок букв не заменяет управление процессом.
Для повторной обработки задайте диапазон. Каждый день можно пересчитывать последние семь дней, а раз в месяц — закрытый период после подтверждения финансов. Баланс зависит от того, как долго источник меняет прошлое.
Метаданные процесса должны отвечать на четыре вопроса: когда запустился, какой объём прочитал, что записал и какие проверки прошёл. Тогда ошибка превращается в конкретный инцидент, а не в загадку.
Что должно быть зафиксировано
- контракт схемы
- зависимости задач
- диапазон пересчёта
- статус готовности витрины
- журнал объёма и проверок
Рабочий план на четыре недели
Пилот нужен не ради ещё одного файла. За месяц команда должна получить воспроизводимый расчёт, увидеть ограничение и принять хотя бы одно решение. Объём специально небольшой: один сегмент, один процесс и один ответственный. Так результат можно проверить, а не объяснять масштабом.
- Неделя 1: выберите один поток, зафиксируйте контракт источника и сделайте контрольный набор.
- Неделя 2: соберите ETL- и ELT-прототипы с одинаковыми проверками и историей.
- Неделя 3: вызовите повторную загрузку, позднее изменение и сбой на середине процесса.
- Неделя 4: сравните полную стоимость, время поддержки, восстановление и требования безопасности.
Перед стартом сохраните исходные значения, правила и дату. После каждого этапа записывайте не только итог, но и время команды, ручные действия и найденные ошибки. В конце сравните результат с исходной точкой и решите: расширяем подход, дорабатываем конкретное место или спокойно закрываем гипотезу. Любой из трёх ответов полезен, если он подтверждён данными.
Назначьте короткую встречу через неделю после пилота. На ней нужен один экран: что изменили, что получилось, где ограничение и какое действие приняли. Если ответ нельзя уместить на одном экране, скорее всего, пилот пытался решить слишком много задач одновременно.
Хороший пилот оставляет после себя рабочий артефакт: проверенную формулу, карту данных, правило процесса или прототип. Назначьте владельца и дату следующей проверки. Без этого даже удачный результат быстро становится презентацией, которую все помнят примерно, а повторить уже не могут (так себе наследство).
Сразу договоритесь о границе масштабирования. Запишите, какой результат считается достаточным, сколько ручной работы допустимо и что должно произойти, чтобы подключить следующий источник, отдел или сегмент. Это защищает от двух крайностей: бесконечного пилота без внедрения и слишком быстрого развёртывания сырого решения на всю компанию. Перед расширением повторите контрольный расчёт на новом участке и убедитесь, что правила не потеряли смысл.
И ещё: сохраните один неудачный пример. Он лучше общей инструкции показывает команде, где метод перестаёт работать, какое ограничение нужно проверить и почему автоматический вывод нельзя принимать без контекста.
Рядом с неудачным примером запишите способ ручной сверки и человека, который принимает решение в спорной ситуации. Тогда исключение не остановит весь процесс и не превратится в новую тайную формулу, известную одному сотруднику.
Ограничения и типичные ошибки
- Сырой слой требует строгих прав, шифрования, сроков хранения и удаления.
- Не переносите всю логику в сотни несвязанных SQL-скриптов без версий и тестов.
- Не игнорируйте лимиты API и поздние изменения данных.
- Не считайте скорость одной загрузки без времени пересчёта моделей.
- Не удаляйте исходную историю до проверки восстановления.
Как мы используем это в работе
Я начинаю с одной цифры отчёта и прохожу путь назад до источника. Затем мы отмечаем, какие преобразования обязательны до хранения, а какие будут меняться вместе с бизнесом.
Маркетингу и финансам отдаём правила показателей, инженерам — контракт данных и проверки. Собственнику показываем не названия подходов, а стоимость, время обновления и сценарий восстановления.
Если загрузки растут быстрее пользы, можно разобрать один поток и выбрать разумный порядок. Кнопка ниже — чтобы обсудить его со мной.
Что сделать прямо сейчас
Возьмите один действующий поток и нарисуйте четыре слоя: источник, сырьё, преобразование, витрина. Отметьте, где теряется история и сколько стоит повторный расчёт.


