

У компании может быть современное хранилище и очень старый вопрос: «Кто отвечает за эту цифру?» Аналитик отвечает за запрос, IT — за сервер, бизнес — за процесс. А за смысл будто никто.
Data Governance — это управление данными: роли, правила, качество, доступ и понятный жизненный цикл. Не папка на сто страниц. Рабочая договорённость, по которой цифрам можно доверять.
Что это такое простыми словами
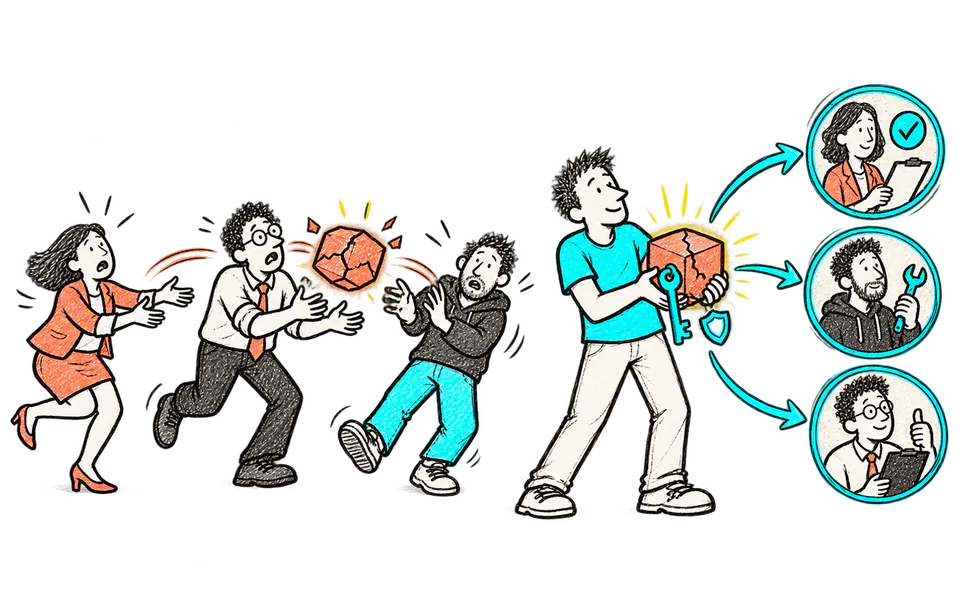
В системе обычно есть владелец данных со стороны бизнеса, ответственный за определение и допустимое качество; steward, который поддерживает описание и решает ежедневные вопросы; технический владелец, отвечающий за платформу и поток.
Каталог помогает найти набор данных, глоссарий — понять термин, lineage — увидеть происхождение, правила качества — заметить проблему, доступы — защитить информацию.
Все элементы нужны не сразу. Если бизнес не знает владельца выручки, покупка большого каталога добавит красивое место для пустого поля.
Зачем это бизнесу
Управление данными сокращает время на поиск и сверку, помогает безопасно давать доступ и быстрее разбирать ошибки. Особенно заметно это при росте числа отчётов и команд.
Для собственника важен результат: ключевая цифра имеет определение, источник, владельца и срок исправления. Для аналитика — меньше археологии. Для IT — понятные требования вместо сообщения «опять всё не сходится».
Governance не должен запрещать любое движение. Хорошая система делает безопасный путь проще, чем обходной.
Как сделать: пошаговый порядок
- Выберите 10–20 критичных элементов данных, влияющих на деньги, клиентов и обязательства.
- Назначьте бизнес-владельца и технического ответственного для каждого элемента.
- Запишите определение, источник, допустимую задержку и правила доступа.
- Добавьте автоматические проверки полноты, уникальности, диапазона и свежести.
- Определите канал инцидента, приоритет и срок реакции.
- Раз в месяц разбирайте повторяющиеся причины и расширяйте охват только после работы первого контура.
Формула или логика расчёта
Качество удобно считать не одним средним, а долей успешных проверок с весом критичности. Например: 10 критичных тестов с весом 3 и 20 обычных с весом 1. Если упал один критичный тест, средний процент не должен спрятать риск.
Подробный пример с числами
В компании 140 отчётов. Еженедельно 18 часов уходило на сверку выручки. Начали не с полного каталога, а с пяти элементов: заказ, оплата, возврат, клиент и рекламный расход.
Для оплаты закрепили источник, дату, статусы и владельца. Добавили проверки: идентификатор уникален, сумма не отрицательна без признака возврата, данные не старше двух часов. За месяц тест сработал семь раз.
Пять случаев были повторной загрузкой, два — задержкой API. После идемпотентности и мониторинга число инцидентов снизилось до одного, время сверки — до четырёх часов в неделю.
Экономия составила 14 часов, но важнее другое: команда знала, кто принимает решение и где проверить проблему. Governance наконец выглядел как помощь, а не новый кружок по заполнению таблиц.
Как измерить, что управление данными работает
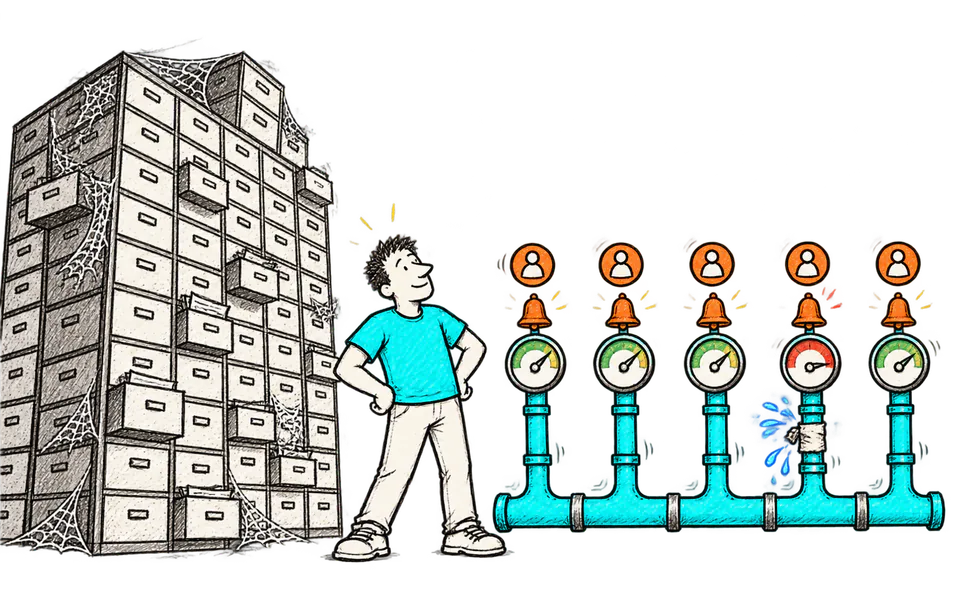
Количество описанных таблиц — слабая метрика. Полезнее измерять долю критичных показателей с владельцем, определением, lineage и автоматической проверкой. Она показывает реальный охват, а не активность по заполнению каталога.
Второй показатель — время реакции на инцидент: от первого сигнала до назначения ответственного и исправления. Разделите критичные и обычные ошибки. Пропавшая выручка за сегодня и пустое необязательное поле не должны стоять в одной очереди.
Третий показатель — повторяемость причин. Если одна и та же проблема возникает каждый месяц, процесс закрывает симптомы. Собирайте категории: источник, контракт, загрузка, формула, доступ, ручное изменение. Улучшение видно по снижению повторов.
Четвёртый — использование доверенных наборов. Если сертифицированная витрина существует, а команды продолжают выгружать данные напрямую, выясните почему. Возможно, витрина медленная, не содержит нужной детализации или о ней никто не знает.
Пятый — время поиска данных и согласования показателя. Его можно замерить коротким опросом и реальными задачами. Цель Governance — ускорять безопасную работу. Если после запуска любой доступ занимает три недели, система нуждается в упрощении.
Показывайте эти метрики вместе с конкретными улучшениями. Например: покрытие критичных данных выросло с 35% до 70%, медианное исправление сократилось с 18 до 6 часов, повторные инциденты — с девяти до трёх. Такая отчётность понятна собственнику.
Короткий чек-лист
- охват критичных элементов
- время реакции и исправления
- повторные причины
- использование доверенных витрин
- время поиска и доступа
- изменения процесса по итогам
Как превратить расчёт в решение
Роли должны иметь полномочия. Если владелец данных отвечает за качество, но не может изменить процесс ввода, ответственность формальная. Запишите, какие решения он принимает и какой ресурс может привлечь.
Доступ стройте по понятным группам и срокам. Временный доступ заканчивается автоматически, а не живёт до следующего аудита. Для чувствительных данных фиксируйте цель использования и журнал действий.
Правила качества связывайте с последствиями. Ошибка в телефоне клиента и ошибка в сумме платежа имеют разную критичность. Приоритет определяет реакцию, а не делает один средний процент качества красивым.
Коммуникация важна не меньше инструмента. Пользователь должен знать, где найти определение, как сообщить об ошибке и когда ждать ответ. Если процесс требует найти правильного человека в трёх чатах, обходной путь победит.
Что должно быть зафиксировано
- полномочия владельцев
- ролевой и временный доступ
- критичность правил качества
- единый канал инцидентов
- понятный срок ответа
Рабочий план на четыре недели
Пилот нужен не ради ещё одного файла. За месяц команда должна получить воспроизводимый расчёт, увидеть ограничение и принять хотя бы одно решение. Объём специально небольшой: один сегмент, один процесс и один ответственный. Так результат можно проверить, а не объяснять масштабом.
- Неделя 1: выберите критичные элементы данных и назначьте владельцев с полномочиями.
- Неделя 2: добавьте определения, доступы и первые автоматические проверки.
- Неделя 3: отработайте тестовый инцидент с каналом, приоритетом и сроком реакции.
- Неделя 4: измерьте охват, время исправления и повторные причины, затем расширяйте контур.
Перед стартом сохраните исходные значения, правила и дату. После каждого этапа записывайте не только итог, но и время команды, ручные действия и найденные ошибки. В конце сравните результат с исходной точкой и решите: расширяем подход, дорабатываем конкретное место или спокойно закрываем гипотезу. Любой из трёх ответов полезен, если он подтверждён данными.
Назначьте короткую встречу через неделю после пилота. На ней нужен один экран: что изменили, что получилось, где ограничение и какое действие приняли. Если ответ нельзя уместить на одном экране, скорее всего, пилот пытался решить слишком много задач одновременно.
Хороший пилот оставляет после себя рабочий артефакт: проверенную формулу, карту данных, правило процесса или прототип. Назначьте владельца и дату следующей проверки. Без этого даже удачный результат быстро становится презентацией, которую все помнят примерно, а повторить уже не могут (так себе наследство).
Сразу договоритесь о границе масштабирования. Запишите, какой результат считается достаточным, сколько ручной работы допустимо и что должно произойти, чтобы подключить следующий источник, отдел или сегмент. Это защищает от двух крайностей: бесконечного пилота без внедрения и слишком быстрого развёртывания сырого решения на всю компанию. Перед расширением повторите контрольный расчёт на новом участке и убедитесь, что правила не потеряли смысл.
И ещё: сохраните один неудачный пример. Он лучше общей инструкции показывает команде, где метод перестаёт работать, какое ограничение нужно проверить и почему автоматический вывод нельзя принимать без контекста.
Рядом с неудачным примером запишите способ ручной сверки и человека, который принимает решение в спорной ситуации. Тогда исключение не остановит весь процесс и не превратится в новую тайную формулу, известную одному сотруднику.
Ограничения и типичные ошибки
- Не назначайте владельцем «отдел». Нужен человек или роль с полномочиями.
- Не описывайте все данные до запуска первых проверок.
- Не измеряйте успех количеством терминов в каталоге.
- Не выдавайте широкий доступ по привычке; используйте минимально необходимый.
- Не наказывайте за найденную ошибку — иначе ошибки перестанут находить.
Как мы используем это в работе
Я начинаю с решений, где ошибка в данных стоит времени или денег. Затем ищу владельца процесса и прохожу путь цифры до источника. Так список правил получается коротким и полезным.
Собственнику показываем здоровье критичных данных и открытые риски. Командам — понятный канал исправления. Маркетингу и финансам — согласованные элементы, на которых строятся их показатели.
Если каталог уже есть, а доверия к цифрам нет, можно запустить управление с одного домена. Кнопка ниже — чтобы обсудить его со мной.
Что сделать прямо сейчас
Выберите пять данных, без которых нельзя закрыть неделю. Для каждого укажите владельца, источник, свежесть и одну автоматическую проверку. Через месяц оцените число и время инцидентов.


